Calcul scientifique & HPC
Calcul scientifique : accélérer vos simulations sans recruter à temps plein
Simulations trop longues, serveurs sous-exploités, coût énergétique : pourquoi optimiser vos codes de calcul, et pourquoi un expert en mission est souvent plus adapté qu’un recrutement en CDI.
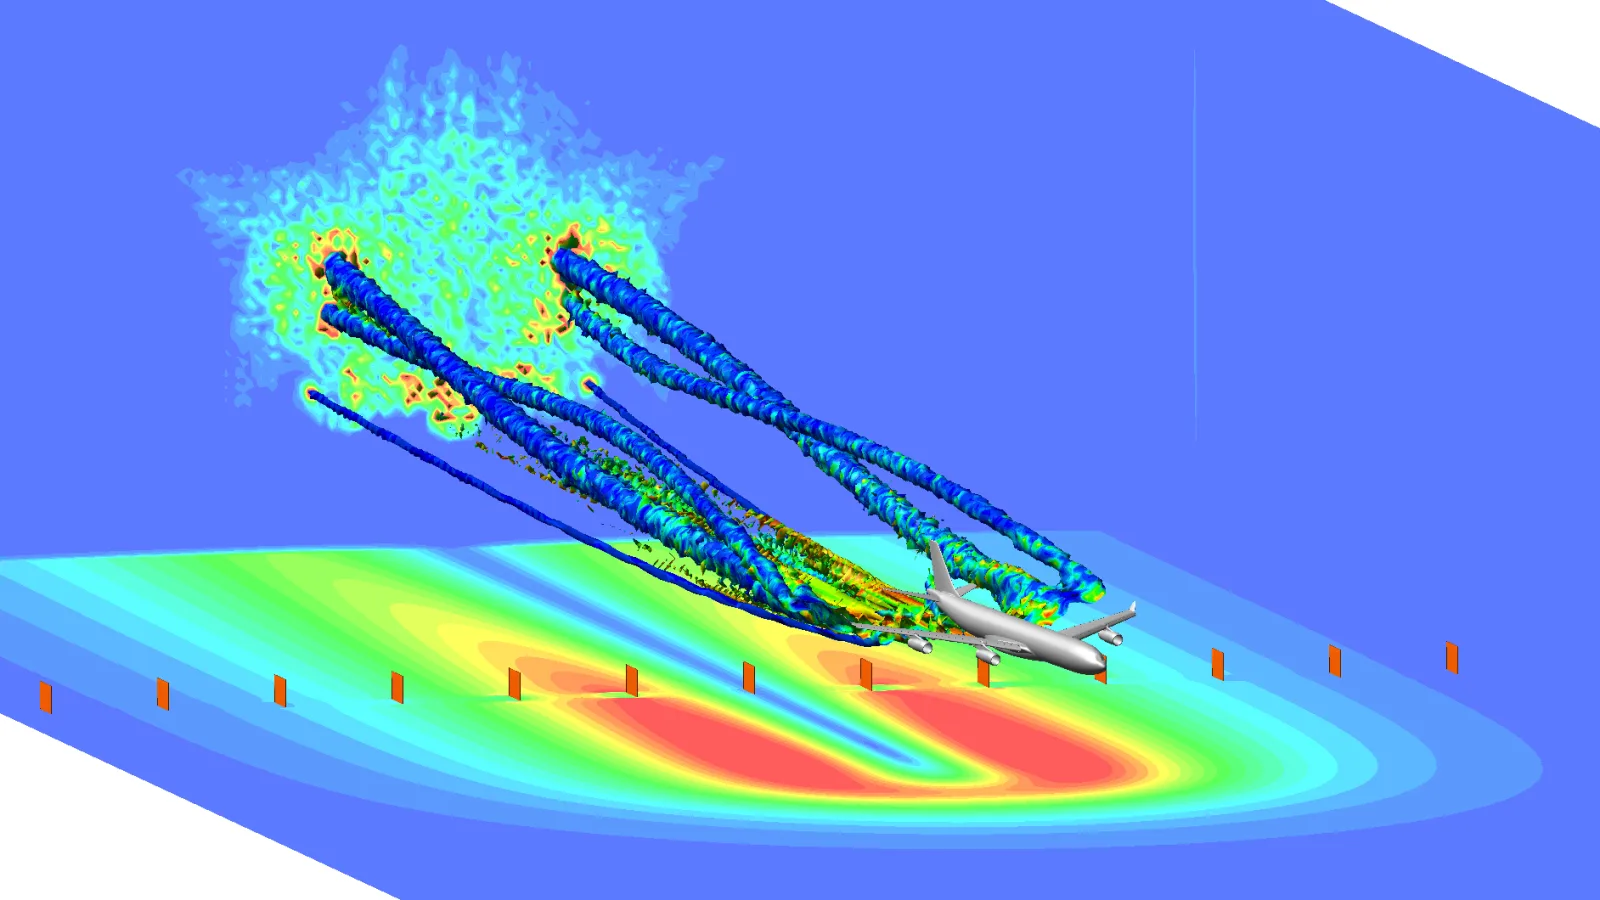
Une simulation de mécanique des fluides qui tourne pendant trois jours, un calcul de structure lancé le vendredi soir pour obtenir un résultat le lundi, un code maison écrit il y a quinze ans par un doctorant parti depuis : dans beaucoup de bureaux d’études et de services R&D, le temps de calcul est devenu un frein au travail d’ingénierie lui-même.
Le réflexe habituel consiste à acheter des machines plus puissantes ou à louer davantage de ressources dans le cloud. Ce n’est pas toujours la bonne réponse. Un code qui n’exploite qu’un seul cœur ne va pas plus vite sur un serveur de 128 cœurs, et une instance GPU louée à l’heure coûte la même chose qu’elle calcule ou qu’elle attende.
Là où le calcul coûte vraiment
Le coût d’une simulation lente ne se lit pas sur la facture d’électricité. Il se mesure en itérations de conception abandonnées : quand un calcul prend deux jours, on teste trois variantes au lieu de vingt, et l’optimisation d’une pièce, d’un échangeur ou d’un procédé s’arrête bien avant d’avoir trouvé le meilleur compromis.
Les situations que nous rencontrons se ressemblent souvent :
- un code historique en Fortran, C ou C++, validé depuis des années, que personne n’ose modifier de peur de casser des résultats de référence ;
- un code parallélisé avec MPI dont les performances plafonnent au-delà de quelques dizaines de cœurs, à cause d’un déséquilibre de charge, de communications trop fréquentes ou d’entrées-sorties mal organisées ;
- des serveurs équipés de GPU achetés pour l’IA, mais que les codes de simulation de l’entreprise n’utilisent pas ;
- des travaux soumis à la main, sans ordonnanceur, si bien que les machines restent inoccupées la nuit pendant que les ingénieurs attendent leur tour en journée ;
- des factures de calcul dans le cloud qui augmentent plus vite que le nombre de simulations réalisées.
Des semaines de calcul : la facture et l’empreinte
Un calcul qui tourne pendant des semaines a un coût direct, souvent sous-estimé. Prenons un ordre de grandeur simple : un serveur de calcul qui consomme 2 kW à pleine charge pendant trois semaines utilise environ 1 000 kWh, auxquels s’ajoute l’énergie du refroidissement de la salle. Dans le cloud, une instance équipée de plusieurs GPU se loue couramment plusieurs dizaines d’euros de l’heure : sur trois semaines, une seule simulation peut représenter plusieurs milliers d’euros, voire davantage. Et un calcul long est rarement lancé une seule fois : il faut le relancer après une erreur de paramétrage, un maillage à reprendre ou une nouvelle variante.
À cela s’ajoute l’impact environnemental. Chaque kilowattheure consommé a une empreinte, plus lourde encore lorsque les serveurs loués sont hébergés dans des pays où l’électricité est fortement carbonée. La fabrication des serveurs et des GPU pèse aussi beaucoup : acheter de nouvelles machines pour compenser un code inefficace alourdit ce bilan.
Le raisonnement inverse est encourageant. Pour un même résultat, un code deux fois plus rapide sur le même matériel consomme environ deux fois moins d’énergie et libère les machines pour d’autres travaux. L’optimisation est l’un des leviers les plus directs pour réduire à la fois les coûts et l’empreinte du calcul scientifique.
Optimiser avant d’acheter
Les gains les plus importants viennent rarement du matériel. Ils viennent de la façon dont le code utilise ce matériel : organisation des données en mémoire, vectorisation, choix des solveurs linéaires et des préconditionneurs, réduction des échanges entre processus, lecture et écriture des fichiers de résultats.
Le portage sur GPU illustre bien ce point. Avec CUDA, certaines parties d’un code de calcul peuvent gagner un ordre de grandeur, à condition que l’algorithme s’y prête et que les données ne fassent pas sans cesse l’aller-retour entre le processeur et la carte graphique. Dans d’autres cas, il est plus pertinent de s’appuyer sur des outils conçus pour ces architectures, comme PyFR pour certains écoulements instationnaires, ou d’optimiser l’utilisation d’OpenFOAM sur des processeurs multicœurs plutôt que de chercher à tout porter.
Ces décisions demandent de comprendre à la fois l’informatique et la physique du problème. Accélérer un calcul en dégradant la convergence, la conservation de l’énergie ou la stabilité du schéma numérique n’a aucun intérêt. Chaque modification doit être validée par rapport à des cas de référence, avec des tolérances définies à l’avance.
Un profil difficile à recruter
La personne capable de faire ce travail doit maîtriser l’analyse numérique, connaître la mécanique ou la thermique du problème étudié, savoir programmer en C++ ou en Fortran, écrire du code CUDA, utiliser MPI et OpenMP, et administrer un environnement de calcul sous Slurm. Ces compétences sont rarement réunies chez une même personne.
Les ingénieurs qui les possèdent sont recherchés par les grands centres de recherche, les industriels de l’aéronautique et de l’énergie, et désormais par les entreprises de l’intelligence artificielle, qui recrutent massivement des spécialistes du calcul sur GPU. Pour une entreprise industrielle de taille moyenne, un recrutement de ce type peut prendre de longs mois, pour un résultat incertain.
Recruter en CDI ou faire appel à un expert en mission
Le besoin d’optimisation est souvent ponctuel. Il faut auditer le code, mener le portage ou la parallélisation, valider les résultats, puis transmettre le travail à l’équipe en place. Une fois ce chantier terminé, le code évolue de nouveau au rythme des projets, et les compétences pointues en calcul haute performance ne sont plus mobilisées à plein temps.
Embaucher un ingénieur en CDI pour ce besoin pose alors plusieurs difficultés : un délai de recrutement long, une période d’intégration avant les premiers résultats, un salaire à la hauteur de la rareté du profil, et le risque que la personne ne trouve plus, après quelques mois, de sujets à la mesure de ses compétences.
Faire appel à un expert externe pour une mission définie présente plusieurs avantages :
- le démarrage est rapide, sans processus de recrutement ;
- le périmètre, les livrables et le budget sont fixés dès le départ ;
- l’effort suit le besoin : intense pendant le portage, réduit ensuite à un suivi ou à des interventions ponctuelles ;
- l’expert apporte des méthodes et des outils déjà éprouvés sur d’autres codes et d’autres architectures ;
- la mission peut inclure une transmission de compétences, pour que vos ingénieurs restent autonomes sur le code optimisé.
Le recrutement en interne reste pertinent lorsque le calcul intensif est au cœur de l’activité et que le volume de développement justifie un poste à plein temps. Dans ce cas, une mission d’audit peut aussi servir à préciser le profil à recruter.
Notre démarche
Nous commençons toujours par un audit du code. Il comprend la lecture des sources, des mesures de performance sur vos cas réels, l’identification des goulets d’étranglement et une estimation des gains atteignables, avec leur coût. Vous savez ainsi où se trouve le potentiel avant d’engager un chantier plus lourd.
Selon les conclusions de l’audit, nous intervenons sur la parallélisation des calculs (MPI, OpenMP), le portage sur GPU avec CUDA, l’organisation des travaux sous Slurm, le réglage de solveurs comme OpenFOAM ou PyFR, et le choix de l’infrastructure : vos propres serveurs ou des serveurs loués, en comparant le coût réel par simulation. Notre compréhension des mathématiques appliquées, de la mécanique et de l’énergie nous permet d’échanger avec vos ingénieurs sur le fond, et de garantir que les résultats restent conformes à vos cas de validation.
Vous avez un code de calcul trop lent ou des serveurs sous-utilisés ? Décrivez-nous votre situation : un premier échange suffit souvent pour savoir si un audit est utile.