Auf Französisch verfügbar
Infrastructures GPU
Serveur GPU pour l’IA : choisir, installer et mettre en service
Serveur GPU dans vos locaux, en cloud ou chez un hébergeur : choix des cartes, Linux, CUDA ou ROCm, stockage, réseau et réception pour mettre en service votre serveur IA.
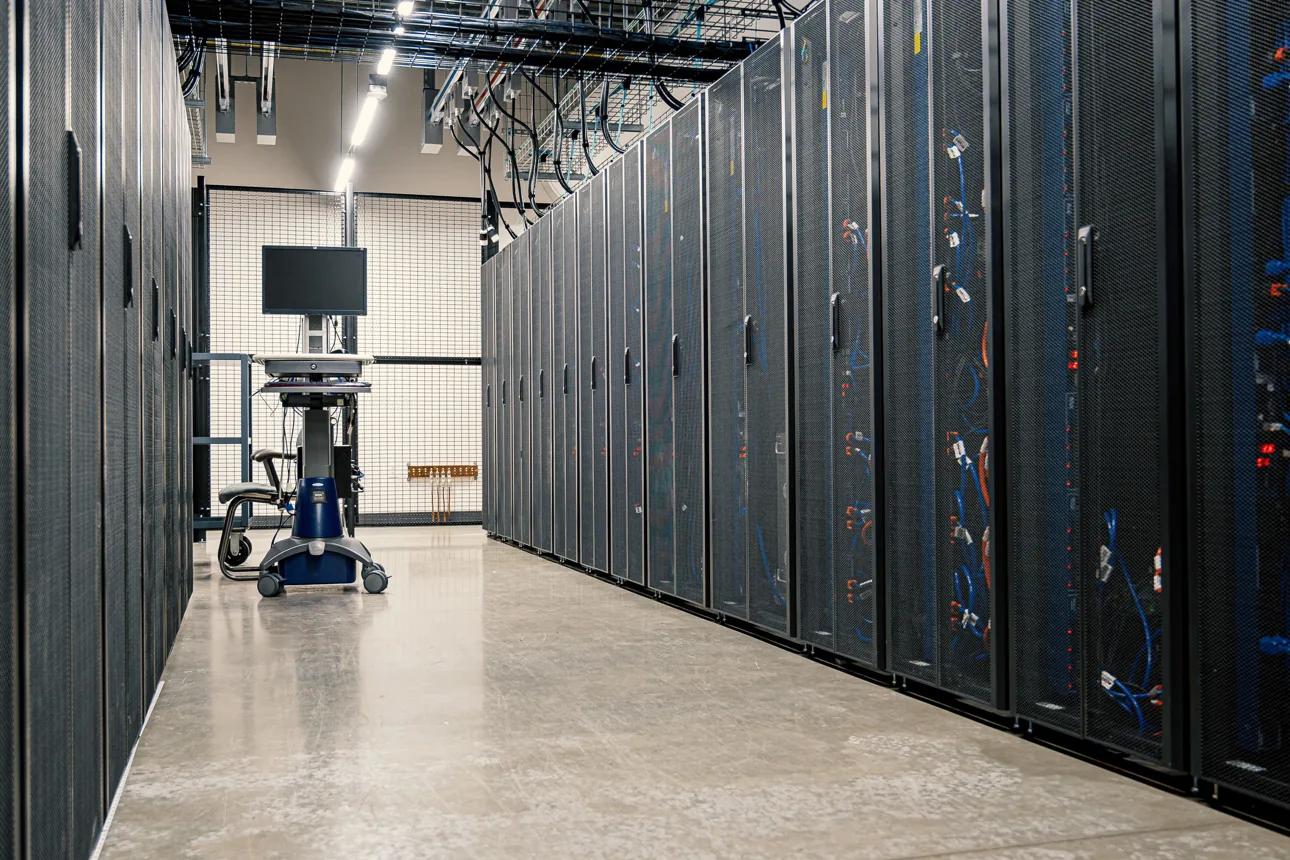
Acheter une machine, louer des ressources ou confier son serveur à un hébergeur : les trois options peuvent répondre à un besoin de calcul. Elles ne répartissent pas les coûts et les responsabilités de la même façon.
La première question : quel travail faut-il exécuter ?
Servir un modèle à plusieurs utilisateurs, lancer des entraînements ponctuels ou faire tourner des calculs longs ne sollicite pas l’infrastructure de la même manière. Avant de comparer les GPU, décrivez la charge et la manière dont elle évolue au fil de la semaine.
Pour un LLM, la mémoire des poids ne représente pas à elle seule toute la mémoire nécessaire. Le contexte, les requêtes simultanées et le moteur d’exécution entrent aussi dans le dimensionnement. Une validation sur un cas représentatif aide à confronter les hypothèses au fonctionnement réel.
Installer dans vos locaux
Vous gardez la machine à proximité. Il faut cependant prévoir l’électricité, le refroidissement, le bruit, la connexion et les personnes qui l’administreront. Une station dans un bureau et un serveur rack n’ont pas les mêmes contraintes.
Précisez ce qui doit rester sur site et ce qui pourrait utiliser des services externes. La localisation de la machine ne suffit pas à décrire tous les flux de données.
Utiliser des ressources cloud
Cette option peut faciliter une expérimentation ou l’accès ponctuel à une configuration. La comparaison doit intégrer le calcul, mais aussi le stockage, les transferts et les services associés.
Vérifiez les configurations réellement disponibles, les conditions de traitement des données et l’effort nécessaire pour retrouver votre environnement. Le cloud et une machine achetée se comparent sur un usage et une durée définis, pas sur deux tarifs isolés.
Faire héberger votre propre serveur
Vous pouvez aussi posséder la machine et la faire installer chez un tiers. Il faut alors confronter la configuration aux contraintes de l’hébergeur : format, puissance, refroidissement, réseau, accès distant et modalités d’intervention.
Pepro peut fournir et préparer le serveur avant son départ. L’hébergement reste une prestation distincte, avec ses conditions et ses responsabilités.
Installer une carte graphique ou mettre en service un serveur IA ?
Installer un GPU dans un ordinateur et livrer un service d’IA à une équipe répondent à deux besoins différents. La carte doit être compatible avec la machine, mais le projet inclut aussi le système, les pilotes, les applications, les données et les personnes qui l’exploiteront.
Pour une station ou un serveur GPU, vérifiez le format, l’alimentation, le refroidissement, les emplacements et liaisons PCIe, la mémoire système et le stockage. La référence de la carte ne permet pas à elle seule de déduire le nombre d’utilisateurs ou le débit de votre application.
Linux, CUDA ou ROCm, Docker, vLLM et Slurm : quel rôle ?
| Composant | Son rôle | Ce qu’il faut valider |
|---|---|---|
| Linux, pilote et CUDA ou ROCm | Rendre l’accélération GPU exploitable par les logiciels. | La combinaison exacte GPU, système, pilote et framework ; toutes les cartes ne sont pas prises en charge. |
| Conteneurs Docker | Préparer un environnement logiciel reproductible. | L’accès au GPU, les dépendances, les données persistantes et les droits. |
| vLLM | Servir des modèles pour l’inférence. | Le modèle supporté, sa mémoire, la longueur du contexte et la charge simultanée. |
| Slurm | Organiser l’accès aux ressources et les travaux partagés. | Les utilisateurs, quotas, files de travaux, applications et stockage. |
Slurm et vLLM ne se remplacent pas : ils peuvent répondre à des besoins complémentaires dans un même projet. Un serveur d’inférence autonome n’a pas nécessairement besoin d’un ordonnanceur de cluster. Le choix dépend de l’organisation et des applications à exécuter.
Dimensionner aussi le stockage et le réseau
Les modèles, jeux de données, versions et résultats n’utilisent pas tous le stockage de la même manière. Distinguez les données à conserver, les fichiers temporaires et les copies de sauvegarde. Le débit utile dépend de l’ensemble de la chaîne : disques, interfaces, réseau et accès simultanés.
Un réseau plus rapide ou un stockage distribué se justifient par la charge et les contraintes d’exploitation. Commencez par décrire les transferts et les applications ; ne choisissez pas une architecture multi-nœuds uniquement parce qu’elle paraît plus évolutive.
Ce qui doit figurer dans la réception
- Références matérielles et versions logicielles retenues.
- Modèle, précision ou quantification, longueur des entrées et sorties, et concurrence utilisées pour l’essai.
- Mémoire occupée, latence, délai du premier jeton et débit dans les conditions décrites.
- Accès aux données, droits, redémarrage et procédure de reprise du périmètre convenu.
- Documentation et responsabilités après la livraison.
Un nombre de jetons par seconde sans modèle, contexte ni charge ne suffit pas pour comparer deux configurations. Pour une machine destinée à un hébergeur tiers, ajoutez ses contraintes de format, puissance, refroidissement, réseau et accès distant avant de commander.
Préparer une station ou un serveur GPU avec Pepro.
Nous étudions le matériel à fournir ou existant, Linux, l’environnement compatible, le stockage, le réseau et la mise en service. Consultez notre démarche de réception et les modalités d’intégration de serveurs GPU.
Décrire mon projet de serveur GPU →Références techniques : dimensionnement et optimisation vLLM ; rôle de Slurm dans le calcul partagé. Retrouvez aussi notre guide des contraintes physiques et énergétiques des infrastructures.